Ниже вся цепочка целиком: лицо, голос, замена лица в готовом клипе, генерация с нуля, перевод и липсинк. С ценами по каждому шагу и с местами, где я сам спотыкался.
Из чего состоит ИИ-модель: лицо, голос, ролик
Разделю сразу, потому что дальше будет путаница. «Ролик со своим лицом» это две совершенно разные задачи, и делают их разные модели:
Первая даёт реалистичность, потому что это настоящая съёмка. Вторая даёт свободу, но картинка получается чище и синтетичнее.
Шаг 1. Лицо: эталонные фото или сгенерированная внешность
Начинается всё со набора эталонных фото. Тут первая неочевидная вещь: моделям нужно очень мало фото. Kling берёт максимум четыре референса, и это жёсткий лимит, а не рекомендация. Так что все инструкции в духе «загрузите 15 фотографий» относятся к обучению своей модели, а не к обычной генерации.
Я прошу у себя 5-8 фото. Не потому, что модель их съест, а чтобы было из чего выбрать лучший кадр под конкретную сцену.

Что реально влияет на результат, по убыванию:
Если своего лица нет
Половина людей, которые это делают, работают с персонажем, которого не существует. Для них есть второй вход: описываешь внешность текстом, и модель рисует четыре кадра одного и того же несуществующего человека.
Тут была техническая ловушка, на которую я напоролся при сборке. Логично сделать четыре запроса с одним и тем же описанием и разными ракурсами. Так получаются четыре разных человека, потому что у модели нет параметра, который зафиксировал бы внешность между запросами. Работает только так: сгенерить первый кадр, а остальные три выводить из него, передавая его как референс. Тогда это один человек.
Поэтому там же есть кнопка «дорисовать ракурсы»: она берёт настоящие фото и достраивает недостающие углы. Если у вас один хороший портрет, этого уже достаточно для старта.

Шаг 2. Клон голоса на русском
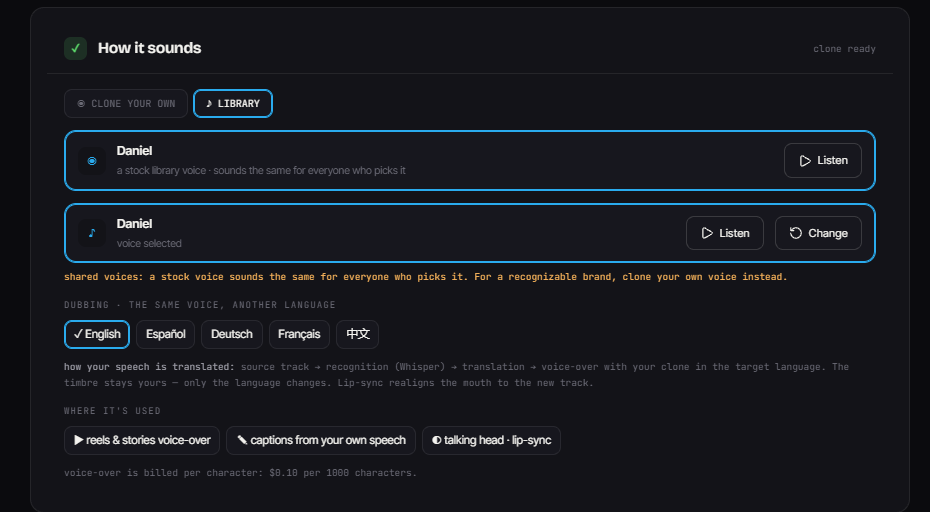
Два способа, и они отличаются не качеством, а уникальностью:
Для клона хватает минуты-полутора. Читайте любой текст ровным голосом, без музыки и без эха в комнате. Дальше этим голосом читается любой текст, и на любом языке: клон держит тембр, меняется только язык.

Библиотека это два десятка готовых голосов, каждый можно прослушать до выбора. Для старта или для персонажа, у которого своего голоса нет, этого достаточно. Но помните, что тот же голос выберут ещё сотни людей: узнаваемости бренда он не даст.
Была ещё третья кнопка, «собрать голос по описанию». Я её убрал: за три доллара модель выдавала результат, который нельзя было послушать до оплаты, и в половине случаев он не нравился. Клон бесплатнее и лучше.
Шаг 3. Замена лица в видео нейросетью. Тут главная грабля
Клип на дорожку, выбрать персону, нажать. И вот место, где чаще всего получается мусор, причём непонятно почему.
Теперь подумайте, что у вас в первом кадре. Затемнение. Титры. Общий план, где вы входите в комнату. Затылок. В любом из этих случаев модели нечего считывать, и замена либо не срабатывает, либо плывёт по всему ролику. А выглядит это как «модель плохая».
Поэтому у нас кадр берётся с текущего положения плейхеда. То есть буквально: поставьте ползунок на момент, где ваше лицо крупно и хорошо видно, и запускайте оттуда. Одно это решает больше, чем все остальные настройки вместе.

Приём, который вытягивает качество сильнее всего
В инструкциях к похожим сервисам встречается совет: соберите эталонное фото на основе первого кадра целевого видео, чтобы свет и ракурс совпали. Дальше идёт промпт строк на двадцать, который надо скопировать в отдельный графический редактор, собрать там портрет и вернуться обратно.
Совет абсолютно верный. Совпадение освещения это второй по важности фактор после крупности лица. Только делать это руками неудобно настолько, что почти никто не делает.
Но клип-то уже лежит на таймлайне. Значит, кадр можно взять самим, отдать его модели вместе с фото персоны и получить персону в том же освещении и ракурсе, что и в кадре. И уже ею делать замену.
У нас это переключатель «подогнать эталон под этот кадр», включён по умолчанию. Стоит 0,08 доллара сверху, то есть примерно треть от цены самой замены. Выключать стоит только если хочется сэкономить на черновике.
Шаг 4. Ролик с нуля: ИИ-аватар по фото и промпту
Здесь исходника нет, и промпт становится единственным, что задаёт кадр. Лицо подставляется как ссылка, которую надо упомянуть в тексте, иначе модель не знает, кто в кадре.
Сравните два промпта. Плохой:
человек танцует под дождём и поёт
Рабочий:
@Image1 танцует под дождём на ночной улице,
средний план, чёрная куртка и джинсы, мокрые волосы,
неоновые отражения в лужах, камера медленно кружит
Разница в том, что во втором указано, кто в кадре, что на нём надето, какая крупность и как движется камера. Всё, чего вы не сказали, модель придумает за вас.
И сразу про пение, потому что это спрашивают чаще всего
Это не недоработка конкретного сервиса. Все видео-модели, которые умеют генерировать звук, придумывают голос сами. Ни одна не принимает ваш клон. Чтобы получился именно ваш голос, нужна цепочка из трёх шагов: сгенерировать видео, озвучить клоном, подогнать губы липсинком. И даже тогда останется ограничение: синтез речи не поёт, он читает. Нормального пения своим голосом сейчас нет нигде, и это стоит знать заранее, чтобы не искать.
Шаг 5. Перевод и липсинк
Самый недооценённый сценарий: у вас есть свой ролик, и вы хотите его на английском своим голосом. Для этого клон голоса даже не нужен: модель дубляжа снимает тембр прямо с дорожки. Загрузили, выбрали язык, получили тот же голос на другом языке.
Дальше про цену, и тут есть важная арифметика.
Дубляж тарифицируется за начатую минуту, с округлением вверх. Это значит, что ролик на 19 секунд стоит столько же, сколько на 59: одну полную минуту. Я на этом сначала посчитал цену пропорционально секундам и ошибся втрое. Если собираетесь переводить много коротких роликов, дешевле склеить их в один и перевести пачкой.
Липсинк это отдельная операция и она в пять раз дороже самого перевода. Поэтому у нас он выключен по умолчанию, с честной пометкой. Без липсинка губы не совпадут, и для говорящей головы это нормально, так работает большинство сервисов дубляжа. Включать стоит, когда лицо крупно в кадре и рассинхрон бросается в глаза.

Сколько это стоит на самом деле
Цены собрал сам, сверяясь со страницами моделей на fal.ai на 12 сентября 2026. Они меняются, так что проверяйте, но порядок такой:
| Операция | Цена | Как считается |
|---|---|---|
| Замена лица, 720p | $0,20 | За клип до 5 сек, дальше вдвое |
| Подгонка эталона под кадр | $0,08 | За изображение |
| Генерация с лицом | $0,14 / сек | Со звуком. Без звука $0,112 |
| Оживление фото | ~$0,30 за 5 сек | За секунду |
| Перевод | $0,60 / мин | За начатую минуту, вверх |
| Липсинк | $3 / мин | Версия pro $5 |
| Озвучка текста | $0,10 / 1000 знаков | Ролик на 30 сек ~$0,05 |
Для сверки: один мой ролик на 5 секунд со звуком обошёлся в 0,28 доллара. Это совпало с расчётом по формуле, так что таблице можно верить.
Короткий чеклист
Если начинаете с X, а не с видео, рядом лежит разбор как раскачать аккаунт в X.
Что пока не работает ни у кого
Чтобы не искали там, где нет:
Последний пункт, кстати, главная причина, почему всё это удобнее делать в редакторе с таймлайном, а не в боте. Разрезать по сценам, прогнать каждую отдельно и склеить обратно там просто нечем.
Вся цепочка из этой статьи собрана в Sndwich
Лицо и голос заводятся в разделе «Персона», своп, ролик и перевод делаются в редакторе, а цены показываются до запуска.
 5 минКак сделать AI-инфлюенсера: что за этим стоит на самом деле
 6 минWan 3 против Seedance 2.5: четыре модели, один клип, один победитель
 6 минЦены API генерации видео: мы платили вдвое за ту же модель и замерили это